[CSAPP] 01.hello 프로그램 하나로 컴퓨터 시스템 이해하기
CSAPP 1장 정리
CSAPP 1장 정리: hello 프로그램 하나로 컴퓨터 시스템 이해하기#
CSAPP 1장을 공부하면서 가장 먼저 든 생각은 hello 같은 간단한 프로그램 하나를 실행하는 데도 컴퓨터 안에서는 꽤 많은 일이 일어난다는 것이었다.
처음에는
hello.c 작성 ↓컴파일 ↓실행 ↓화면에 Hello, World! 출력정도로 생각했다.
그런데 실제로는 C 소스 코드가 여러 단계를 거쳐 기계어로 변환되고, 실행 파일이 디스크에서 메모리로 올라오고, CPU가 메모리에 있는 인스트럭션을 읽어 실행한다. 그 과정에서 운영체제와 캐시, 프로세스, 가상 메모리 같은 개념도 연결된다.
이번 장에서는 hello 프로그램 하나를 따라가면서 컴퓨터 시스템이 어떻게 동작하는지 정리해봤다.
1. 컴퓨터는 우리가 작성한 코드를 바로 이해하지 못한다#
우리가 C로 작성하는 코드는 사람이 읽기 쉽게 만들어져 있다.
예를 들어 다음과 같은 코드가 있다.
#include <stdio.h>
int main(){    printf("hello, world\n");    return 0;}
사람에게는 printf를 이용해서 문자열을 출력하는 코드라는 것이 보인다.
하지만 CPU가 이런 C 코드를 직접 읽고 실행하는 것은 아니다.
CPU가 실행하는 것은 기계어 인스트럭션이다.
컴퓨터에서 데이터는 결국 비트인 0과 1로 표현된다. 8비트가 모이면 1바이트가 되고, C 소스 코드에 작성된 문자들은 문자 인코딩을 통해 숫자로 표현된다.
초기 컴퓨터 시스템에서 대표적으로 사용된 문자 인코딩이 ASCII다.
예를 들어 문자 A는 ASCII에서 숫자 65로 표현되고, 컴퓨터 내부에서는 이 값이 비트로 저장된다.
따라서 우리가 작성한 hello 라는 문자도 컴퓨터 내부에서는 문자에 대응하는 숫자와 비트로 저장된다.
중요한 것은 소스 코드 자체가 곧 기계어라는 뜻은 아니라는 것이다.
소스 코드는 사람이 작성한 텍스트이고, CPU가 실행하려면 이것을 기계어 인스트럭션으로 변환하는 과정이 필요하다.
2. C 소스 코드는 어떻게 실행 파일이 될까?#
C 프로그램을 작성하고 실행할 때는 여러 단계의 변환이 일어난다.
전체적인 흐름은 다음과 같다.
hello.c ↓전처리기 ↓hello.i ↓컴파일러 ↓hello.s ↓어셈블러 ↓hello.o ↓링커 ↓실행 파일 hello이 네 가지 과정을 묶어서 컴파일 시스템이라고 한다.
2.1 전처리 단계#
처음에는 우리가 작성한 hello.c 소스 파일이 있다.
전처리기는 컴파일하기 전에 소스 코드를 준비한다.
대표적으로#include <stdio.h> 와 같은 전처리 지시문을 처리한다.
전처리 과정이 끝나면 hello.c → hello.i 가 된다.
처음에는 전처리기가 printf 같은 함수까지 직접 실행하거나 컴파일한다고 생각했는데, 정확하게는 전처리기는 컴파일 전에 소스 코드를 전처리하는 단계라고 이해하는 것이 좋았다.
2.2 컴파일 단계#
전처리된 hello.i는 컴파일러에 의해 어셈블리어로 변환된다.
hello.i → hello.s어셈블리어는 기계어와 가까운 형태의 저급 언어다.
예를 들어 C 코드가 return 0;처럼 작성되어 있어도 CPU가 그대로 이해하는 것이 아니라, CPU가 실행할 수 있는 형태에 가까운 어셈블리어 명령으로 변환된다.
2.3 어셈블리 단계#
다음은 어셈블러가 어셈블리어를 기계어로 변환하는 단계다.
hello.s → hello.o이때 만들어지는 hello.o는 재배치 가능한 목적 파일(relocatable object file)이다.
여기서 처음에는 hello.o를 바로 실행할 수 있는 실행 파일이라고 생각했는데, 정확하게는 아직 링크가 끝나지 않은 상태다.
기계어 형태의 코드와 데이터가 들어 있지만 다른 목적 파일이나 라이브러리와 연결하는 과정이 남아 있다.
2.4 링크 단계#
마지막은 링커가 담당한다.
hello.o +필요한 라이브러리 코드 ↓실행 파일 hello예를 들어 우리가 사용하는
printf("hello, world\n");의 printf 함수는 우리가 hello.c 안에서 직접 구현한 함수가 아니다.
표준 C 라이브러리에서 제공하는 함수다.
링커는 프로그램에서 사용하는 외부 함수나 다른 목적 파일 및 라이브러리와 필요한 부분을 연결해서 최종 실행 파일을 만든다.
이 과정을 링크(linking)라고 한다.
결국 우리가 실행하는 hello는 여러 과정을 거쳐 만들어진 실행 가능한 목적 파일이다.
3. 왜 굳이 컴파일 과정을 알아야 할까?#
처음에는 그냥 컴파일 버튼을 누르면 프로그램이 실행되는데, 이런 과정을 공부해야 하나 싶었다.
하지만 CSAPP에서는 컴파일 시스템을 이해하는 것이 여러 가지 이유로 중요하다고 설명한다.
프로그램 성능 최적화#
컴파일러가 소스 코드를 어떻게 기계어로 바꾸는지 알면 프로그램의 성능을 생각할 때 도움이 된다.
링크 이해#
프로그램을 작성하다 보면 undefined reference 같은 링크 관련 오류를 만날 수 있다.
코드 자체에는 문제가 없어 보이는데 프로그램이 만들어지지 않는 상황을 이해하려면 링커가 무엇을 하는지 알아야 한다.
보안#
버퍼 오버플로우 같은 보안 취약점을 이해하려면 프로그램이 메모리에 어떻게 배치되고 실행되는지 알아야 한다.
결국 컴파일 시스템은 단순히 C → 실행 파일로 바꾸는 과정만 공부하는 것이 아니었다.
소스 코드가 실제 CPU에서 실행되는 코드가 되기까지의 과정을 이해하는 것이라고 생각했다.
4. 실행 파일을 실행하면 무슨 일이 일어날까?#
컴파일이 끝났다고 해서 프로그램이 바로 CPU에서 실행되는 것은 아니다.
실행 파일은 먼저 디스크에 저장되어 있다.
터미널에서 ./hello 처럼 프로그램을 실행하면 쉘(shell)이 명령을 해석한다.
여기서 터미널과 쉘을 구분할 필요가 있었다.
터미널  ↓사용자가 명령어를 입력할 수 있는 환경
쉘  ↓입력된 명령어를 해석하고 실행
터미널은 우리가 명령어를 입력하고 결과를 보는 창이라고 생각하면 편하다.
쉘은 그 안에서 입력한 명령어를 해석하는 프로그램이다.
예를 들어
ls를 입력하면 쉘은 ls라는 명령을 찾아 실행한다.
실행 파일 이름을 입력하면 쉘은 해당 프로그램을 실행한다.
프로그램이 실행되고 나면 화면에 결과가 출력되고 프로그램은 종료된다. 그러면 쉘은 다시 사용자의 다음 입력을 기다린다.
5. 컴퓨터 하드웨어는 어떻게 구성되어 있을까?#
hello 하나를 실행하는 과정에서도 여러 하드웨어가 사용된다.
CSAPP에서는 크게 다음과 같은 구조로 설명한다.
CPU │ │ 메모리 │ │ ┌─────────┴─────────┐ │ │ 입출력 장치 저장장치 키보드/마우스 SSD/HDD조금 더 자세하게 보면 버스와 컨트롤러 같은 구성 요소도 있다.
5.1 버스#
버스(bus)는 컴퓨터 시스템의 여러 구성 요소 사이에서 데이터와 신호를 전달하는 통로다.
쉽게 생각하면 컴퓨터 내부의 여러 장치가 정보를 주고받을 때 사용하는 통로라고 생각할 수 있다.
버스는 데이터를 일정한 크기의 단위인 워드(word) 단위로 전송하도록 설계될 수 있다.
워드의 크기는 시스템에 따라 달라질 수 있다.
5.2 입출력 장치#
키보드, 마우스, 디스크, 모니터 같은 장치가 입출력 장치에 해당한다.
CPU가 모든 장치와 직접 통신하는 것이 아니라 여러 컨트롤러나 어댑터 등을 통해 정보를 주고받는다.
컨트롤러와 어댑터의 구체적인 차이는 구현 방식과 패키징 방식에 있지만, 지금 단계에서는 CPU와 입출력 장치 사이에서 통신을 담당하는 장치 정도로 이해했다.
5.3 메인 메모리#
메인 메모리, 즉 RAM은 프로그램이 실행되는 동안 프로그램의 코드와 데이터를 저장하는 공간이다.
대표적으로 DRAM이 사용된다.
프로그램이 디스크에 저장되어 있다고 해서 CPU가 디스크에서 모든 인스트럭션을 바로 실행하는 것은 아니다.
실행에 필요한 프로그램과 데이터가 메인 메모리에 올라오고 CPU가 이를 이용해 프로그램을 실행한다.
6. 프로세서는 어떻게 프로그램을 실행할까?#
CPU를 이해하면서 가장 중요했던 것 중 하나가 프로그램 카운터(PC)였다.
프로세서는 메모리에 있는 인스트럭션을 읽고 실행한다.
프로세서 내부에는 레지스터들이 있고, 그중 프로그램 카운터(PC)는 다음에 실행할 인스트럭션의 주소를 가리키는 데 사용된다.
프로그램은 인스트럭션들이 순서대로 실행되는 것처럼 보인다.
대표적인 동작을 단순하게 정리하면 다음과 같다.
적재(Load)#
메모리 → 레지스터
메모리에 있는 데이터를 레지스터로 가져온다.
저장(Store)#
레지스터 → 메모리
레지스터에 있는 데이터를 메모리에 저장한다.
연산#
레지스터의 값을 ALU로 보내 연산하고 결과를 다시 레지스터에 저장할 수 있다.
레지스터 ↓ ALU ↓레지스터ALU는 산술 연산과 논리 연산 등을 수행하는 장치다.
점프#
프로그램 카운터의 값을 변경해서 다음에 실행할 인스트럭션의 위치를 바꾼다.
PC ↓다음 인스트럭션 위치 변경그래서 if, for, while, 함수 호출 같은 프로그램의 흐름도 결국 CPU가 실행하는 인스트럭션들의 동작으로 표현된다.
7. hello 프로그램이 실제로 실행되는 과정#
이제 앞에서 공부한 내용을 하나로 연결해봤다.
먼저 우리가 작성한 프로그램은 컴파일 시스템을 거쳐 실행 파일이 된다.
hello.c ↓전처리 ↓컴파일 ↓어셈블 ↓링크 ↓실행 파일 hello실행 파일은 디스크에 저장되어 있다.
사용자가 쉘에서 ./hello 를 입력하면 쉘이 프로그램 실행을 요청한다.
운영체제는 실행 파일을 실행하기 위한 준비를 하고, 프로그램의 코드와 필요한 데이터를 메모리에 적재한다.
그 다음 CPU가 프로그램의 인스트럭션을 실행한다.
hello 프로그램이 문자열을 출력하면 그 결과가 입출력 시스템을 거쳐 화면에 나타난다.
전체적인 흐름을 단순하게 정리하면 다음과 같다.
hello.c ↓ 컴파일 시스템 ↓ 실행 파일 hello ↓ 디스크 ↓ 메인 메모리 ↓ CPU ↓ 인스트럭션 실행 ↓ 입출력 장치 ↓ 화면처음에는 프로그램을 실행하면 CPU가 디스크에 있는 파일을 바로 읽어서 실행한다고 생각했는데, 실제로는 저장장치에 있는 프로그램이 실행을 위해 메모리에 적재되고 CPU가 메모리의 코드와 데이터를 이용해 실행한다는 흐름으로 이해했다.
8. CPU가 빠른데 왜 캐시가 필요할까?#
컴퓨터 시스템을 공부하면서 또 하나 헷갈렸던 부분이 캐시였다.
프로그램을 실행하려면 데이터를 계속 이동시켜야 한다.
예를 들어 디스크 → 메인 메모리 → CPU 처럼 데이터가 이동한다.
문제는 저장장치마다 속도가 다르다는 것이다.
대략적인 관계는 다음과 같다.
빠름↑레지스터L1 캐시L2 캐시L3 캐시메인 메모리SSD/HDD↓느림위쪽으로 갈수록 일반적으로 빠르고 용량이 작으며 가격이 비싸다.
아래쪽으로 갈수록 느리지만 용량이 크고 바이트당 비용이 저렴하다.
CPU와 메인 메모리의 속도 차이가 크기 때문에 CPU가 메모리의 데이터를 기다리는 시간이 생길 수 있다.
그래서 CPU와 메인 메모리 사이에 캐시 메모리를 둔다.
캐시는 왜 효과가 있을까?#
프로그램에는 지역성(locality)이라는 특성이 있기 때문이다.
쉽게 말하면 프로그램은 데이터를 완전히 무작위로 사용하는 경우보다 최근에 사용한 데이터나 가까운 위치의 데이터를 다시 사용할 가능성이 높은 경우가 많다.
예를 들어 반복문에서 배열의 데이터를 순서대로 읽는다면 비슷한 위치의 데이터를 계속 사용할 가능성이 높다.
이런 데이터를 캐시에 미리 가져다 놓으면 CPU가 느린 메인 메모리까지 매번 접근할 필요가 줄어든다.
CPU ↓L1 ↓L2 ↓L3 ↓메인 메모리 ↓SSD/HDD캐시는 용량은 작지만 빠르다.
그래서 자주 사용할 가능성이 높은 데이터를 가까운 곳에 저장해서 메모리 접근 시간을 줄이는 것이 캐시를 사용하는 이유라고 이해했다.
9. 저장장치는 계층구조를 이룬다#
캐시를 공부하다 보니 저장장치가 각각 따로 존재하는 것이 아니라 하나의 계층 구조를 이루고 있다는 것도 알게 됐다.
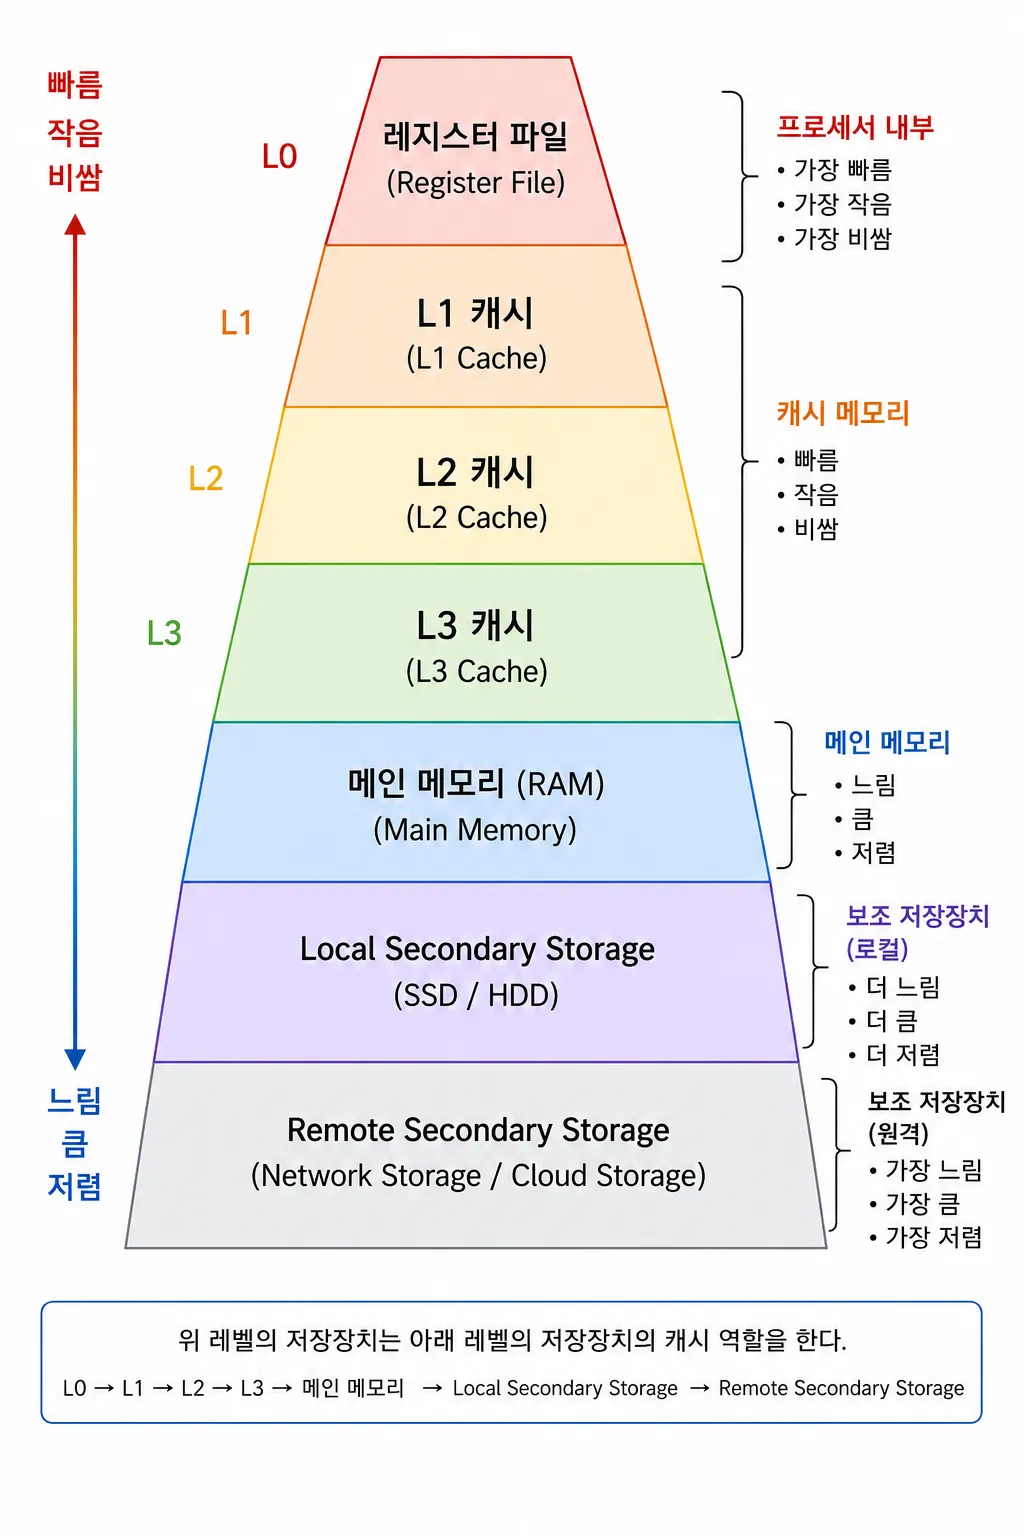
위로 갈수록
- 빠르다
- 작다
- 비싸다
아래로 갈수록
- 느리다
- 크다
- 저렴하다
여기서 기억해두고 싶은 문장은 이것이다.
각 레벨의 저장장치는 아래 레벨의 저장장치에 대한 캐시 역할을 한다.
예를 들어 캐시는 메인 메모리에서 자주 사용하는 데이터를 가져와 저장하고, 메인 메모리는 디스크에 저장된 프로그램과 데이터를 실행하기 위해 활용한다.
결국 전체 저장장치를 하나의 거대한 저장공간처럼 사용하는 것처럼 보이면서도 실제로는 여러 단계의 저장장치를 조합해서 성능과 용량을 동시에 얻는다.
10. 운영체제는 하드웨어와 프로그램 사이에 있다#
컴퓨터에는 수많은 하드웨어가 있다.
그런데 개발자가 프로그램을 작성할 때 CPU나 디스크의 구체적인 하드웨어 구조를 매번 직접 다뤄야 한다면 너무 복잡할 것이다.
여기서 운영체제가 등장한다.
운영체제는 응용 프로그램과 하드웨어 사이에서 여러 기능을 제공한다.
응용 프로그램 ↓ 운영체제 ↓ 하드웨어운영체제는 크게 두 가지 목적을 가진다고 이해했다.
첫 번째는 프로그램이 하드웨어를 잘못 사용하지 못하도록 보호하는 것이다.
두 번째는 서로 다른 하드웨어를 프로그램이 일관된 방식으로 사용할 수 있도록 인터페이스를 제공하는 것이다.
이때 등장하는 개념이 추상화다.
11. 추상화란 무엇일까?#
추상화는 복잡한 내부 동작을 숨기고 우리가 필요한 기능만 사용할 수 있도록 만드는 것이다.
예를 들어 파일을 생각해보면 된다.
우리는 파일을 읽을 때
open()read()같은 방식으로 파일을 사용할 수 있다.
그런데 실제 하드웨어에서는 디스크의 특정 위치에서 데이터를 읽고 장치와 통신하는 여러 과정이 필요하다.
우리는 이런 내부 과정을 매번 신경 쓰지 않아도 된다.
운영체제가 복잡한 하드웨어를 추상화해서 프로그램이 사용하기 편한 형태로 제공하기 때문이다.
CSAPP에서 특히 기억하고 싶은 운영체제의 추상화는 다음 세 가지다.
파일 ↓입출력 장치의 추상화
가상 메모리 ↓메인 메모리 + 디스크의 추상화
프로세스 ↓프로세서 + 메인 메모리 + 입출력 장치의 추상화
12. 프로세스란 무엇일까?#
프로세스는 실행 중인 프로그램에 대한 운영체제의 추상화다.
예를 들어 크롬을 실행하고 음악 플레이어도 실행하고 터미널도 실행할 수 있다.
사용자 입장에서는 여러 프로그램이 동시에 실행되는 것처럼 보인다.
CPU가 하나였던 시절에는 실제로는 한 번에 하나의 프로그램만 실행하고, 아주 짧은 시간 간격으로 다른 프로그램으로 바꾸는 방식으로 여러 프로그램이 실행되는 것처럼 보이게 만들었다.
이것을 문맥 전환(context switch)이라고 한다.
프로그램 A 실행 ↓ 잠시 멈춤 ↓프로그램 B 실행 ↓ 잠시 멈춤 ↓프로그램 A 실행운영체제는 프로세스가 사용하던 상태를 저장하고 다른 프로세스의 상태를 복원하면서 실행 대상을 바꾼다.
그래서 사용자는 여러 프로그램이 동시에 실행되는 것처럼 느낄 수 있다.
여기서 커널(kernel)이 등장한다.
커널은 운영체제의 핵심 부분으로, 프로세스 관리나 메모리 관리, 입출력 같은 중요한 작업을 담당한다.
응용 프로그램이 운영체제의 기능을 요청하면 시스템 콜(system call)을 통해 커널에게 요청할 수 있다.
13. 쓰레드는 프로세스 안의 실행 흐름이다#
프로세스 안에는 하나 이상의 쓰레드(thread)가 존재할 수 있다.
쓰레드는 프로세스의 실행 흐름이라고 생각하면 이해하기 편했다.
같은 프로세스에 속한 쓰레드들은 같은 코드와 전역 데이터를 공유할 수 있다.
프로세스 ├── 쓰레드 A ├── 쓰레드 B └── 쓰레드 C여러 쓰레드를 사용하면 하나의 프로그램 안에서도 여러 작업을 동시에 진행하는 구조를 만들 수 있다.
14. 가상 메모리#
가상 메모리도 처음에는 이름부터 어렵게 느껴졌다.
쉽게 정리하면
각 프로세스가 자신만의 독립적인 메모리 공간을 가지고 있는 것처럼 보이게 하는 것
이라고 이해했다.
예를 들어 프로그램 A와 프로그램 B가 실행되고 있다고 하자 각 프로세스는 자신의 메모리를 사용하는 것처럼 보인다.
그래서 한 프로그램이 다른 프로그램의 메모리 영역을 마음대로 건드리지 못하도록 보호할 수 있다.
가상 메모리의 구조#
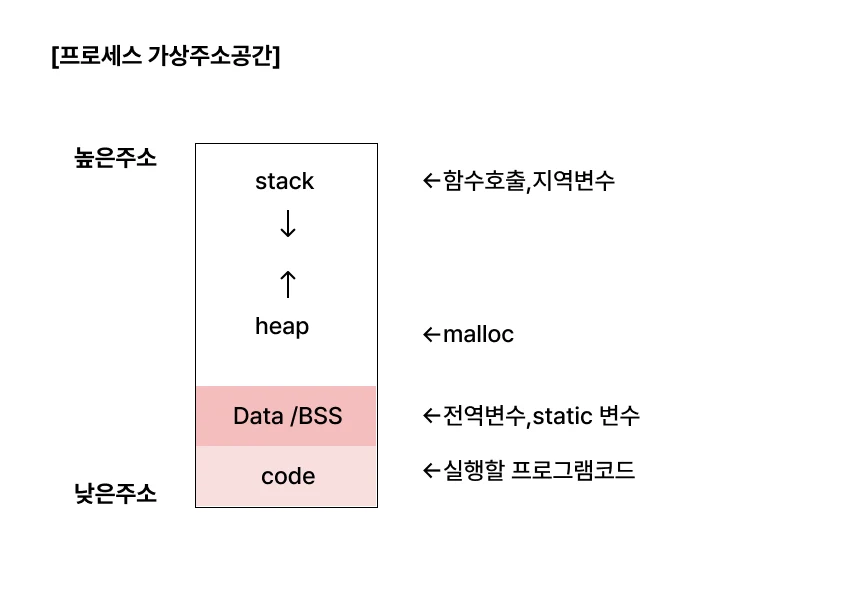
일반적인 프로세스의 가상 주소 공간을 단순하게 표현하면 다음과 같이 볼 수 있다.
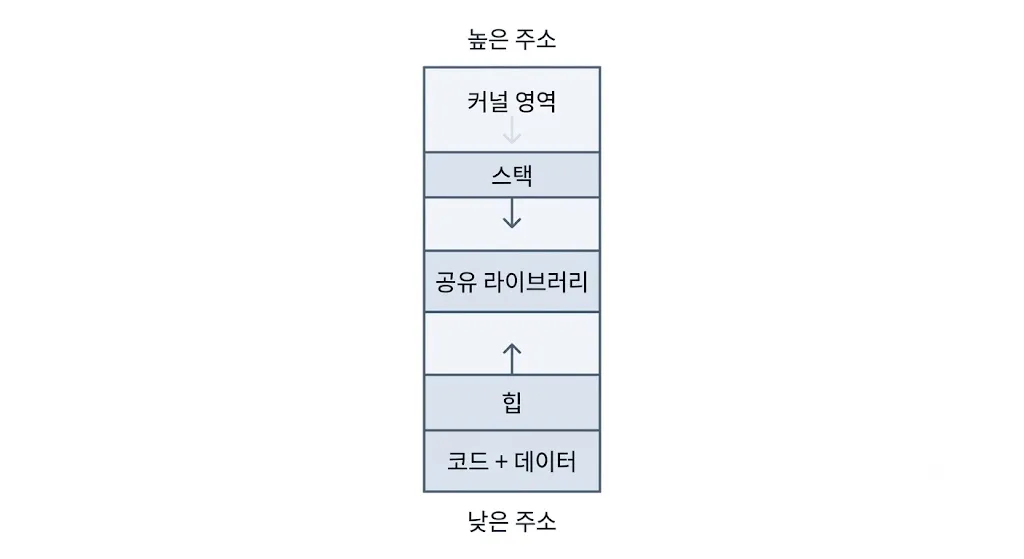
코드와 데이터#
실행 파일의 프로그램 코드와 전역 데이터 등이 위치한다.
힙#
프로그램 실행 중 동적으로 메모리를 할당하는 공간이다.
예를 들어 C에서는 malloc() 등을 이용해서 힙 영역의 메모리를 사용할 수 있다.
공유 라이브러리#
여러 프로그램에서 사용할 수 있는 공유 라이브러리의 코드와 데이터가 배치될 수 있다.
스택#
함수 호출과 관련된 데이터를 저장하는 영역이다.
함수를 호출하면 스택에 필요한 정보가 쌓이고 함수가 반환되면 다시 정리된다.
커널 영역#
운영체제 커널이 사용하는 영역이다.
응용 프로그램이 이 영역을 마음대로 사용할 수 없도록 보호된다.
15. 파일은 입출력의 추상화다#
유닉스 계열 시스템에서는 입출력을 파일이라는 일관된 형태로 다룬다.
디스크의 파일을 읽거나 쓰는 것뿐만 아니라 여러 입출력 장치도 파일과 비슷한 인터페이스를 통해 다룰 수 있다.
이렇게 하면 프로그램이 하드웨어의 구체적인 구현 방식에 지나치게 의존하지 않아도 된다.
그래서 CSAPP에서
파일은 입출력 장치의 추상화다.
라고 설명하는 것이다.
16. 컴퓨터는 네트워크를 통해 다른 컴퓨터와 통신한다#
현대의 컴퓨터는 혼자 사용되는 경우보다 네트워크에 연결되어 있는 경우가 많다.
예를 들어 웹 브라우저에서 서버에 요청을 보내면 데이터가 네트워크를 통해 다른 컴퓨터로 이동한다.
간단하게 보면
내 컴퓨터 ↓네트워크 어댑터 ↓네트워크 ↓다른 컴퓨터내 컴퓨터에서 생성한 데이터가 네트워크를 통해 다른 시스템으로 전달될 수도 있고, 다른 컴퓨터에서 받은 데이터가 내 컴퓨터의 메모리로 들어올 수도 있다.
결국 컴퓨터 시스템의 입출력은 로컬 저장장치에만 한정되지 않는다.
네트워크 역시 컴퓨터 시스템에서 중요한 입출력 경로다.
17. Amdahl의 법칙#
CSAPP 1장에서 가장 기억하고 싶은 성능 관련 개념 중 하나가 Amdahl의 법칙이다.
쉽게 말하면
프로그램의 일부분만 아무리 빠르게 만들어도 전체 프로그램의 성능 향상에는 한계가 있다.
예를 들어 프로그램 실행 시간의 90%를 차지하는 부분을 10배 빠르게 만들었다고 하자.
나머지 10%는 그대로다.
그러면 전체 프로그램이 10배 빨라지는 것은 아니다.
Amdahl의 법칙은 이런 상황에서
어디를 개선해야 전체 성능이 가장 많이 좋아지는가?
를 생각할 때 사용할 수 있다.
대표적인 식은 다음과 같다.
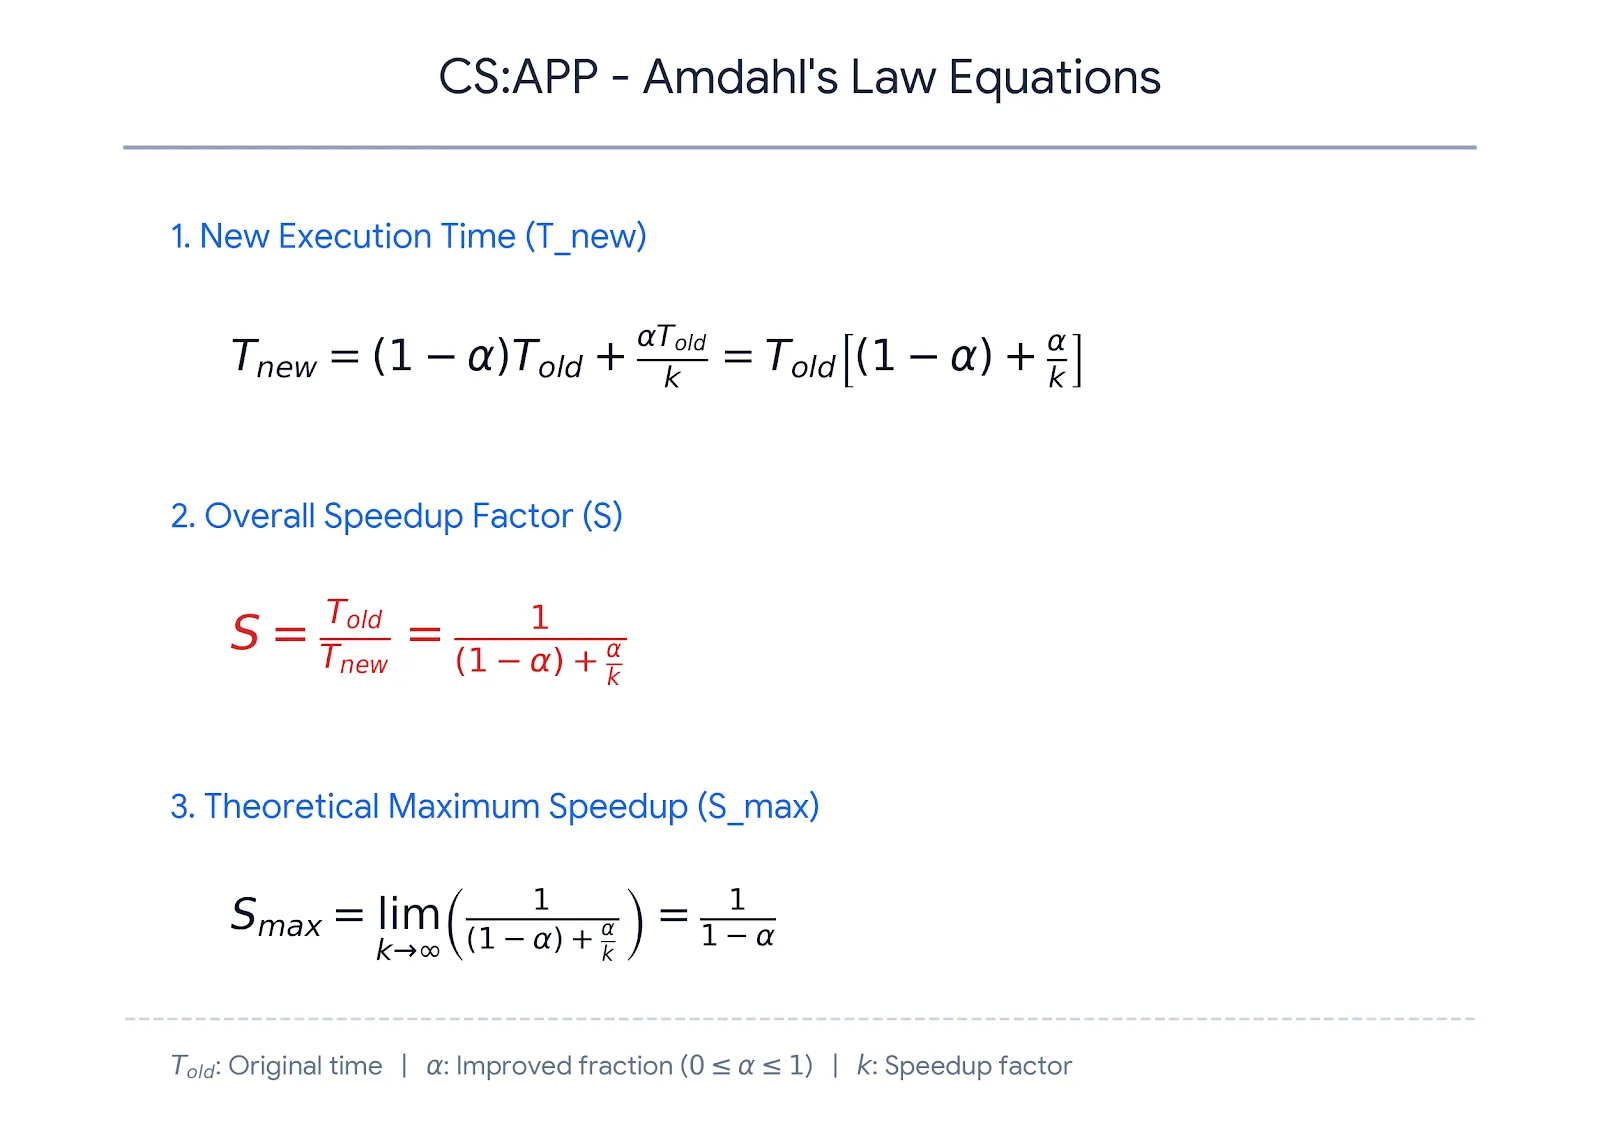
α = 개선할 부분이 전체 실행 시간에서 차지하는 비율.
k = 개선한 부분이 몇 배 빨라졌는지
예를 들어 전체 프로그램의 90%를 10배 빠르게 만든다면
α = 0.9
k = 10 이다.
1 / (0.1 + 0.9/10) 이므로 전체 성능 향상은 10배가 아니라 약 5.26배 정도다.
여기서 배울 수 있는 것은 명확했다.
한 부분의 성능만 계속 개선한다고 해서 전체 프로그램이 같은 비율로 빨라지는 것은 아니다.
그래서 성능을 개선할 때는 먼저 프로그램에서 시간이 어디에 많이 사용되는지 파악해야 한다.
18. 동시성과 병렬성#
동시성과 병렬성은 비슷하게 들려서 처음에는 구분하기 어려웠다.
동시성#
여러 작업을 다루는 구조를 말한다.
CPU가 작업을 번갈아 실행하면서 여러 작업이 진행되는 것처럼 보일 수도 있다.
병렬성#
여러 작업을 실제로 동시에 실행해서 성능을 높이는 것을 말한다.
예를 들어 CPU에 여러 코어가 있다면 여러 코어가 각각 작업을 수행할 수 있다.
싱글 코어
CPU ↓A → B → A → B

멀티 코어
CPU 1 → ACPU 2 → B
19. 쓰레드 수준의 동시성#
하나의 프로세스 안에서 여러 쓰레드를 실행할 수 있다.
프로세스 ├── Thread 1 ├── Thread 2 └── Thread 3멀티코어 CPU에서는 여러 쓰레드를 실제로 여러 코어에서 병렬 실행할 수도 있다.
반대로 코어가 하나라면 운영체제가 쓰레드를 번갈아 실행하면서 동시성을 구현할 수 있다.
20. 멀티코어와 멀티프로세서#
멀티코어 프로세서는 하나의 CPU 칩 안에 여러 개의 프로세서 코어를 포함한다.
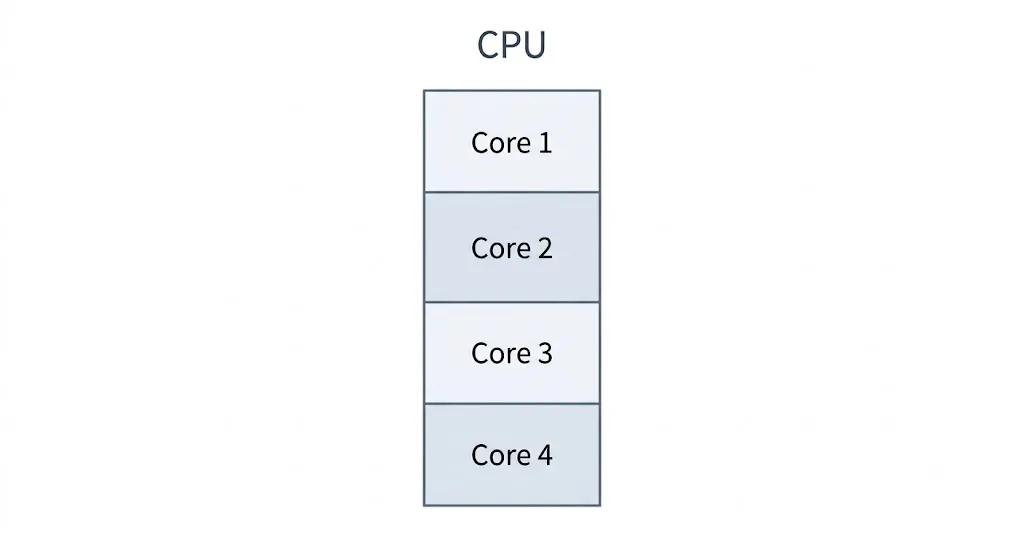
여러 코어가 있기 때문에 여러 작업을 실제로 병렬 처리할 수 있다.
멀티코어 시스템에서 프로그램을 여러 쓰레드로 잘 나누면 하나의 프로그램을 더 빠르게 실행할 수도 있다.
다만 프로그램이 병렬 실행에 적합하게 작성되어 있어야 한다.
코어가 많다고 모든 프로그램이 자동으로 같은 비율로 빨라지는 것은 아니다.
이 부분도 Amdahl의 법칙과 연결된다.
21. 인스트럭션 수준 병렬성#
병렬성은 쓰레드에서만 나타나는 것이 아니다.
CPU 내부에서도 여러 인스트럭션을 병렬적으로 처리할 수 있다.
한 사이클에 여러 인스트럭션을 실행할 수 있는 프로세서를 슈퍼스칼라 프로세서라고 한다.
또한 SIMD(Single Instruction, Multiple Data)는 하나의 인스트럭션으로 여러 데이터를 동시에 처리하는 방식이다.
예를 들어 같은 연산을 여러 숫자에 반복해서 수행해야 한다면 SIMD를 이용해서 한 번에 여러 데이터를 처리할 수 있다.
하나의 인스트럭션 ↓┌──────┬──────┬──────┬──────┐│ data │ data │ data │ data │└──────┴──────┴──────┴──────┘ ↓ 여러 데이터에 같은 연산22. 컴퓨터 시스템에서 추상화가 중요한 이유#
1장을 공부하면서 계속 반복해서 등장한 개념이 추상화였다.
처음에는 서로 다른 개념이라고 생각했다.
파일프로세스가상 메모리함수API그런데 모두 비슷한 생각으로 연결할 수 있었다.
복잡한 내부 동작을 숨기고 사용자가 필요한 부분만 사용할 수 있도록 만드는 것이다.
예를 들어 함수도 추상화의 한 형태라고 볼 수 있다.
result = sum(numbers)라고 작성하면 sum() 내부에서 어떤 방식으로 반복문을 실행하는지 매번 알 필요가 없다.
운영체제도 비슷하다.
프로그램이 디스크의 실제 하드웨어 구조를 직접 다루지 않고 파일이라는 형태로 사용할 수 있도록 해준다.
프로세스 역시 CPU와 메모리의 복잡한 동작을 숨기고 프로그램 하나가 독립적인 컴퓨터에서 실행되는 것처럼 보이게 한다.
23. CSAPP 1장을 하나의 흐름으로 정리#
결국 1장에서 공부한 내용은 따로 떨어져 있는 개념들이 아니었다.
hello 프로그램 하나를 실행하는 과정을 따라가면 대부분 연결된다.
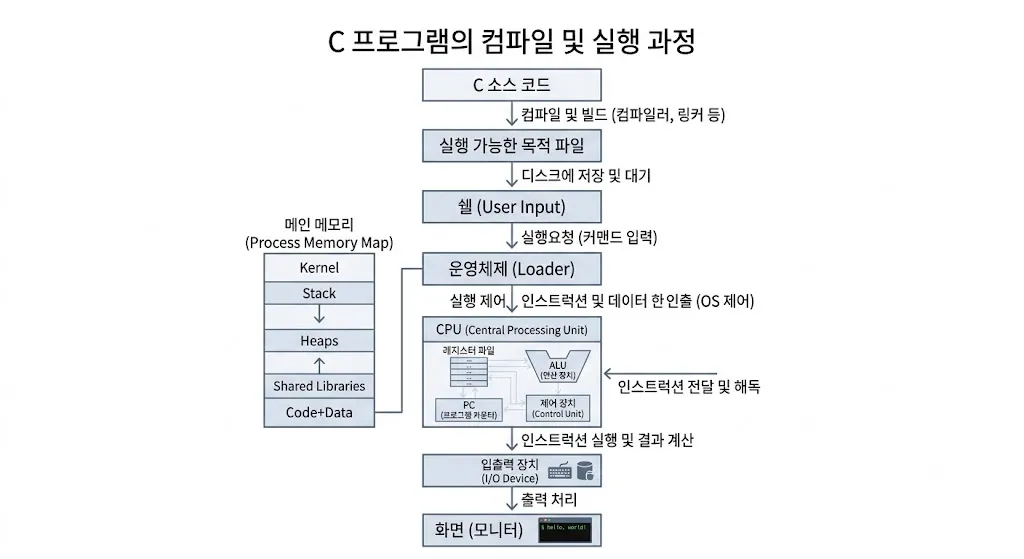
그리고 CPU가 메모리와 데이터를 주고받는 과정에서 캐시가 사용되고, 저장장치는 계층 구조를 이룬다.
운영체제는 프로세스와 가상 메모리, 파일 등의 추상화를 제공하고 여러 프로그램이 실행될 수 있도록 관리한다.
네트워크를 사용하면 이 시스템이 다른 컴퓨터와 연결된다.
마지막으로 성능을 생각할 때는 Amdahl의 법칙을 통해 어떤 부분을 개선해야 전체 성능이 좋아지는지 생각할 수 있다.
24. 이번 장을 공부하고 내가 이해한 방식#
처음에는 hello.c가 실행되는 과정이 그냥
코드 작성 → 컴파일 → 실행이라고만 생각했다.
CSAPP 1장을 공부하고 나서는 조금 다르게 보이기 시작했다.
사람이 이해하는 C 코드 ↓컴파일 시스템 ↓CPU가 실행할 수 있는 기계어 ↓디스크에 저장 ↓운영체제가 실행 준비 ↓메모리에 적재 ↓CPU가 인스트럭션 실행 ↓입출력 장치를 통해 결과 출력그리고 이 과정 곳곳에 여러 개념이 연결되어 있었다.
컴파일러   ↓기계어
CPU   ↓레지스터 / ALU / PC
메모리   ↓캐시 / 지역성
운영체제   ↓프로세스 / 가상 메모리 / 파일
여러 작업   ↓동시성 / 병렬성
성능 개선   ↓Amdahl의 법칙
전체 시스템   ↓추상화
결국 CSAPP 1장에서 가장 크게 느낀 것은 프로그램은 단순히 코드만 실행되는 것이 아니라 컴퓨터 시스템의 여러 계층을 거쳐 실행된다는 것이었다.
앞으로 프로그래밍을 공부할 때도 코드가 실행된다는 말을 단순히 함수가 호출되고 결과가 나온다는 의미로만 생각하지 않고, 그 아래에서 CPU와 메모리, 운영체제가 어떤 일을 하는지도 같이 생각해보려고 한다.