[CSAPP] 가상메모리 malloc이란?
malloc에 대해 알아보자
malloc에 대해 알아보자#
malloc이 뭐에요?#
malloc은 힙이다! 정도까지 알던 내가 이번 csapp 9.9의 내용을 읽으면서 조금 더 깊게 파게된것같다.
프로세스부터 알아야되는데 프로세스는 프로그램이 실행이 되면 프로세스가 된다.
이게 뭔소리냐면 만약 c프로그램을 실행하면 운영체제는 프로그램을 실행하기 위해서 프로세스를 만든다는 말이다.
여기서 프로세스는 자신만의 가상주소 공간을 갖는데 프로세스가 보는 주소하고 실제 ram 물리주소하고는 다르다는것을 참고하고 먼저 짚고 넘어간다.
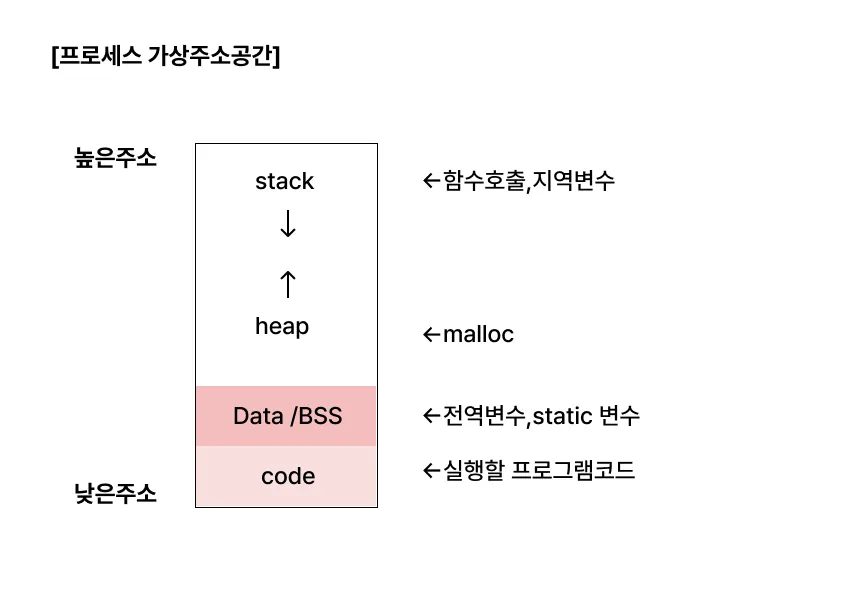
(각 운영체제 아키텍처에서 예외사항이있을수있으니 그냥 개념적으로 생각하시면 될듯)
그럼 Heap은 뭐에요?#
여기서 malloc을 알려면 heap을 알아야된다
void foo() { int x = 10;}위 코드를 보면 x처럼 함수가 호출되고 끝나면 수명이 끝나는 지역변수는 스택이라는 곳에 놓이게되는데
int *p = malloc(sizeof(int));이 malloc 함수를 쓰게되면 얼마나 오래 사용할지 런타임에 결정되는 메모리가 필요하다 이때 사용하는 공간이 heap이라는것이다
좀 어려우니까 쉽게 설명하자면 프로그램 실행중에 메모리가 필요할때 빌려쓰는곳이라 생각하면 쉽다
보통 프로그램을 만들다보면 실행하기전에 얼마나 많은 메모리가 필요하지?를 한번쯤고민해봤을것인데 프로그램을 실행하기전까지는 얼마만큼의 메모리가 필요한지 모르기때문에, 프로그램 실행이 되는중에 메모리가 더 필요하니까 빌려달라고 요청해서 그 사용할수있는공간이 heap이라는 것이다!
아까 위 코드처럼 int 하나 4바이트를 저장할수있는 공간을 할당해서 빌려쓰는것이다 대신 빌려주면 꼭 다시 반환을 해줘야된다.
지금까지 heap에 대해 설명했는데 이 heap을 쓸려면 malloc 함수를 사용한다 생각하면 된다.
malloc은 어떤식으로 동작하는지?#
malloc을 사용하는방식에 대해 먼저 간단하게 설명하고 후반부에 깊게 짚고 넘어가겠다
int *arr = malloc(sizeof(int) * 5);위코드는 malloc(heap)에 int 4바이트 짜리 5개를 저장할공간을 주겠다! 라고 생각해보자 즉 heap에 malloc이 들어가는것이다
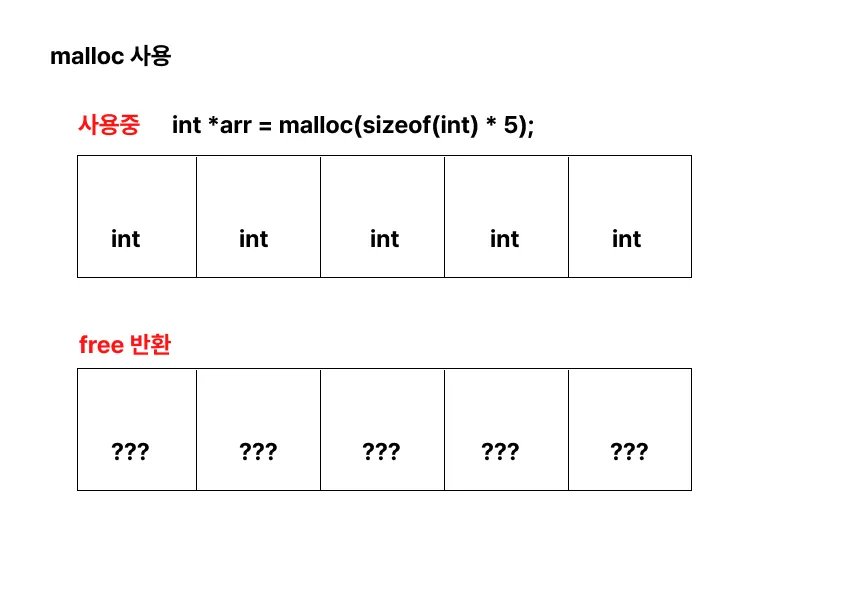
그림을 보면 이렇게 5개가 들어가게되고 만약 공가에 값을 넣게 되고나서 다 사용을 하게되면 무조건 반환을 해줘야된다 이때 반환은 free라는 것을 사용한다
좀 쉽게 말하자면 malloc은 필요한만큼 빌려주고 free는 다시 반환하는것이라고 생각하자
free는 공간이 없어졌다라기보다 내가 사용할수있는 메모리에서 빠지고 다시 사용할수있는 상태가 된다 라고 이해해야된다 한마디로 예전의 주소가 남아있을 수 있다는것인데 free한 공간을 다시 사용하게 되면 use after free라는게 발생할수있다.
use after free: 프로그램이 이미 free 된 힙 메모리영역에 접근하거나 다시 사용하려고 할때 발생하는 메모리 취약점이다
그럼 기본적인 malloc은 이해했으니 이제 더 들어가서 malloc의 기본역할과 동적위치에대해 알려주겠다.
malloc의 기본역할과 동적위치#
힙영역에서 동작: 가상 메모리 공간에서 프로그램이 실행되는 동안 동적으로 메모리를 사용할 수 있는 Heap을 관리한다. 이때 brk라는 경계값을 통해 현재 Heap의 끝이 어디인지 나타낸다.
brk는 breakpoint 약자로 현재 heap의 끝이 어디인지 나타내는 경계점이다
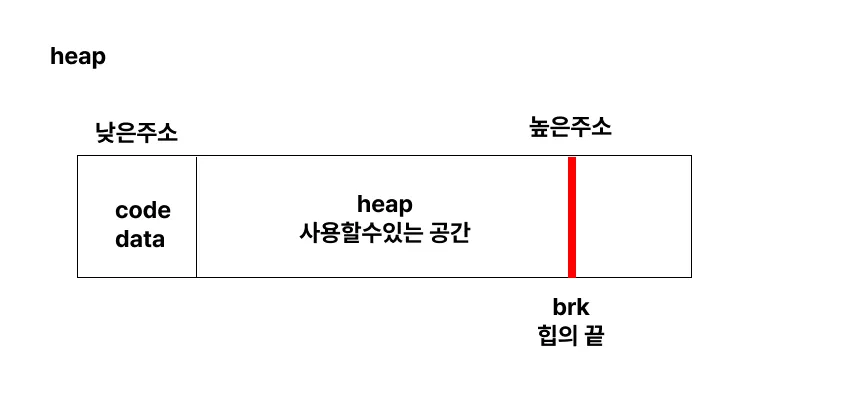
힙을 확장하면 brk가 이동하면서 높은주소로 간다는 말입니다
포인터 반환: 사용자가 요청한 크기 이상의 메모리 블록을 할당한 후 해당블록 첫번째 바이트를 가리키는 포인터를 반환한다. 할당을 실패할시 null을 반환한다
힙확장: 힙내부의 가용메모리로 요청을 충족할수없을 경우 커널 sbrk()시스템콜이라는것을 호출해서 brk포인터를 올려 힙공간을 확장한다.
다음은 힙에 더 깊게 들어가보도록 하겠다
힙 내부#
좀 쉽게 메모리 공간 한칸을 1블록이라고 설명해보겠다
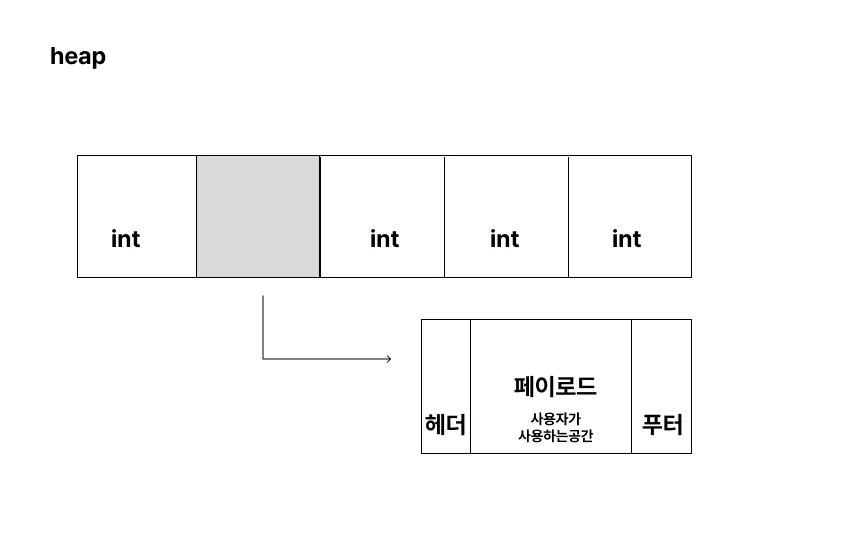
위 이미지를 보면 이해할수있을지 모르겠지만 힙에서 하나의 블록으로 확대를 해보면 위 이미지처럼 구성이 되어있다
payload(페이로드)는 사용자가 malloc(size)를 통해 실제로 요청하여 데이터를 저장하는공간이다
header(헤더)는 메모리 블록의 맨 앞에 붙어 있는 관리 정보인데 이 블록이 얼마나 큰지, 그리고 현재 사용 중인지 같은 정보를 저장하는것이다 근데 여기서 크기와 사용여부를 어떻게 같이 저장하는지?에서 의문이 들수있는데, 메모리는 일정한 크기로 정렬해서 관리하기 때문에 블록 크기의 하위 바이트는 0이된다. 그래서 이 비트를 그냥 버리진않고 이 블록이 사용중인지 아닌지 나타내는 표시인 플래그라는것을 활용한다
여기서 메모리 블록은 몇으로 정렬해서 관리하는거지? 싶을수있는데 보통 8바이트 단위로 정렬해서 관리하는데 블록크기 8의 배수가 되고 이진수로 표현하게되면 3비트가 남아서 항상 0이되는것이다.. 그래서 어차피 사용을 하지않으니까 플래그를 쓰는것이다..
이제 malloc의 내부 4단계 처리과정을 알려주겠다!
malloc의 내부 4단계 처리과정#
먼저 짚기전에 가용블록이라는 뜻을 이해해보자. 가용블록은 이전에 힙에 할당되었지만 free()가 되어서 다시사용할수있는 상태 블록을 가용블록이라고 한다. 이어서 4단계 처리과정은
- 요청 크기 보정: 사용자가 요청한 size에 헤더와 패딩크기를 더한 뒤 정렬제약 및 최소 블록 크기 요건에 맞게 할당한 블록 크기를 올림 계산한다
- 가용블록탐색: 힙 내부의 가용(free)블록목록(Implict,Explicit,Seglist 등) 순회 하면서 보정된 크기를 수용할수있는 가용블록을 찾는다
- 블록분할: 찾은 가용블록이 요청한 크기보다 충분히 크다면 필요한 크기만큼만 할당블록으로 바꾸고 남은 부분은 새로운 가용블록으로 분할한다
- 힙 확장:가용리스트에서 적절한 블록을 찾지못하면 sbrk()를 호출해 커널에 힙공간 확장을 요청하고 새 가용블록을 확보한다.
free 함수의기본역할과 특징#
가용블록의 말이 나와서 free 함수 역할에 대해 이야기해보고자 한다
역할을 위에 초반에 설명했듯이 malloc으로 할당받았던 힙메모리 블록을 다시 가용(free) 상태로 전환하여 이후 다른 malloc요청에서 재사용할수있도록 할당자에게 반환한다
NULL포인트 처리: free(NULL)을 호출하면 아무런 작업하지않고 리털한다 주소제약: ptr(포인터)는 반드시 이전 malloc,calloc,realloc이 반환했던 payload의 첫번째 주소여야한다! (블록 중간주소나 힙이 아닌 주소를 넘기면 정의되지않은 동작/크래시가 발생한다.)
여기서 realloc에 잠깐 소개하자면 이미 할당되어있는 메모리 블록의 크기를 동적으로 변경할때 사용하는 c표준 라이브러리다!
경계태그 상수연결#
연결을 수행할때 다음 블록은 현재 블록 header 크기만큼 주소를 더하면 쉽게 찾을수있다. 하지만 이전 블록의 시작위치와 상태는 어떻게 단번에 알아낼수있을까??
경계태그에 대해 알아보자. 할당자는 각 가용블록의 맨끝에 header의 복사본인 footer을 추가로 저장한다
아까 힙 내부안 블록에 보면 이렇게 푸터가 있기에 끝을 알수있는것이다
free시 발생하는 연결케이스#
- 인접한 블록이 없으므로 현재 블록만 가용처리
- 현재 블록과 다음 블록을 하나로 합침
- 이전,다음 3개 블록을 모두 합체 하나의 큰 가용블록으로 만든다
이제 어느정도 heap에 대해 알았으니 동적인 메모리를 할당할때 두개의 기본유형을 설명해주겠다
동적메모리 할당의 요구사항은?#
지금까지 동적 메모리 할당을 이해하기 위해 Heap이 어떤 공간인지 살펴봤다.
동적 메모리란 프로그램이 실행되는 동안 필요에 따라 메모리를 할당하고 사용하는 것이다. 이때 동적 메모리를 관리하는 방법에는 명시적 할당과 묵시적 할당이 있다.
명시적 할당은 프로그램이 직접 메모리를 할당하고 사용이 끝난 후에 반환하는 방식이고, 묵시적은 프로그램이 직접 메모리를 반환하지않아도 메모리 관리 시스템이 더이상 사용하지않는 메모리를 알아서 회수 하는 방시인데 여기서 가비지컬렉션이라는 언어를 사용하는게 대표적이다 (java나 go같은…)
이런 동적 메모리를 만들기 위해선 도전해야될 핵심목표 과제가 있는데 간단하게 설명해주겠다
malloc 설게핵심 목표 도전과제#
두가지 대립되는 성능목표 사이에서 균형을 잡아야된다
- 처리량 극대화: 단위시간당 처리할수있는 malloc 및 free 요청 수를 극대화한다 (탐색할당시간을 단축한다는것)
- 메모리 이용률 최대화: 단편화 현상을 줄여서 제한된 가상메모리를 효율적으로 사용하는것이다
단편화에는 두가지가 있는데 내부단편화와 외부단편화가 있다. 내부단편화: 요청된 payload(페이로드)보다 실제 할당된 크기가 커서 내부공간이 남는현상 외부단편화: 전체 가용메모리 합은 요청크기보다 크지만 이들이 여러조각으로 쪼개져 있어 연속된 하나의 큰 블록을 제공하지 못하는 현상
아래 그림으로 이해하면 쉬울수있다
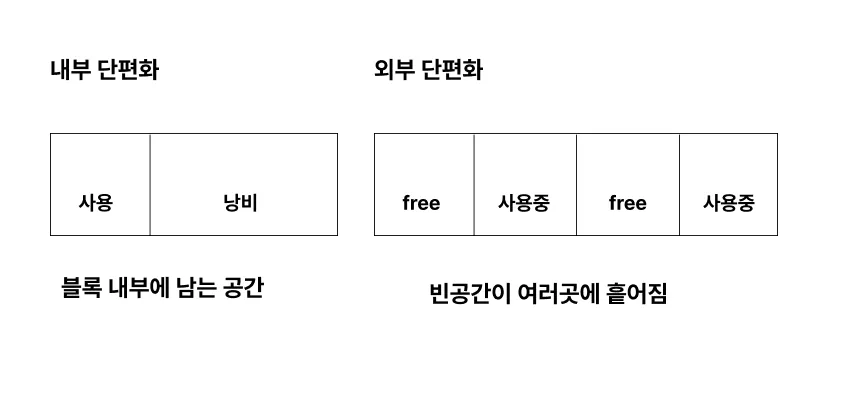
한무자으로 정리하면 내부단편화는 할당한 공간 안에서 낭비가 발생하는것이고 외부단편화는 할당하지 않은 공간이 흩어져서 낭비되는것으로 생각하면 될것같다.
우리는 이제 힙에 처리량시간과,메모리를 효율적으로 사용하는것에 도전과제를 두고 만들어야된다!
묵시적 가용리스트에 대해#
이것을 알기전에 워드단위를 짚고넘어가야될것같은데,워드(word)는 cpu가 한번에 처리하기 위해 자연스러운 기본 데이터 크기를 의미하고 시스템에 따라 달라질수있으니 참고! 대부분의 컴퓨터는 요즘 32비트와 64비트 컴퓨터가 대부분인데
1bye = 8bits 이기 때문에 1워드는 8byte를 써서 64bits인것이다..
갑자기 워드를 설명하는이유는 malloc은 아무 크기로나 메모리를 막 할당하는게 아니라 정렬규칙을 고려해서 블록 크기를 조정해야된다..
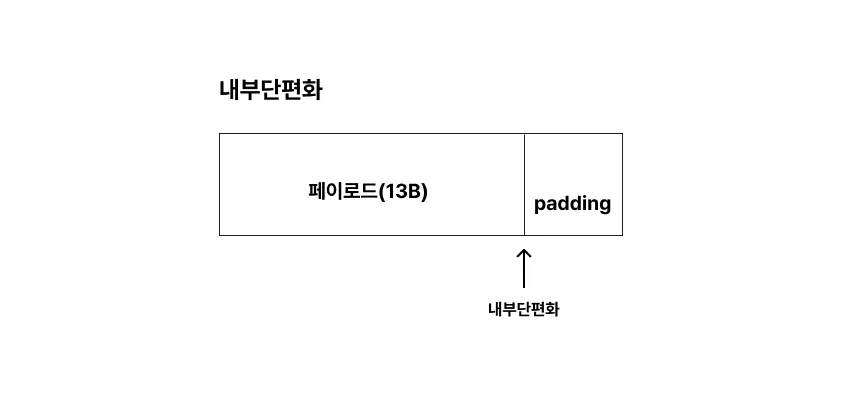 예를들어서 8바이트 정렬규칙을 사용하면 malloc(13)을 요청하게되면 정렬은 실제 블록크기가 16byte(8바이트 단위)를 할당하게되는데 아까 13을 요청하게되면 나머지공간이 남게되서 padding이 발생한다! 이것을 내부단편화가 발생한다고 하는것이다..
이제 다시 본론으로 돌아가…묵시적할당기하고는 아까 설명한것과 다르니 햇갈리면 안된다! (아깐 개념설명)
묵시적 가용 리스트(implicit free list)를 사용해서 가용블록을 관리하는 것에 대해 알아보자
묵시적 가용리스트는 heap에 있는 블록들을 순서대로 살펴보면서 가용블록을 찾는 방식이다
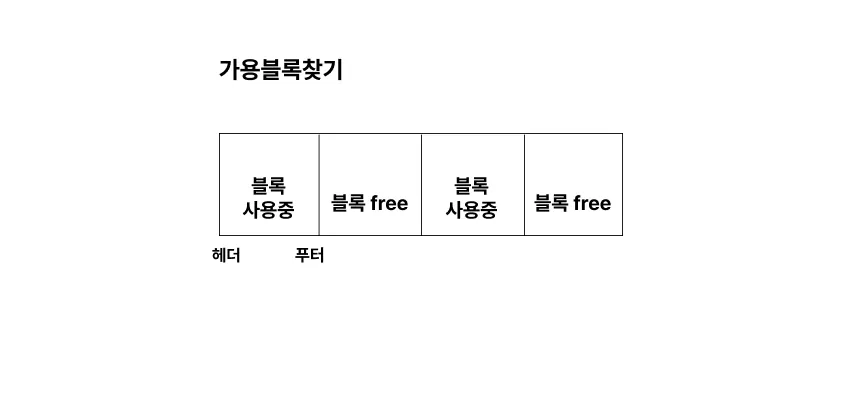
묵시적 가용리스트는 이미지로 보면 이해하기 편하다 따로 free 블록만 연결하는게 아니라 heap에 있는 모든 블록들을 처음부터 끝까지 순회해서 이 블록이 사용중인지 free인지 내가요청한 크기를 담을수있는지 판단하는것이다 힙의 탐색 끝을 알려주기위해서 크기는 0인데 할당비트가 1로 설정된 특별한 에필로그 헤더를 맨끝에 둔다는 점이있다
장점은 구조와 구현이 단순하고 가용포인터를 유지하기 위한 추가적인 메모리 오버헤드가 적다는것인데.. 단점은 메모리를 할당할때 가용블록 뿐만아니라 이미 할당된 블록도 포함해서 보니 힙전체를 순회해야되서 탐색시간이 올라가서 비효율적이다는것이다..
그림으로 설명을 좀 더 해보자면
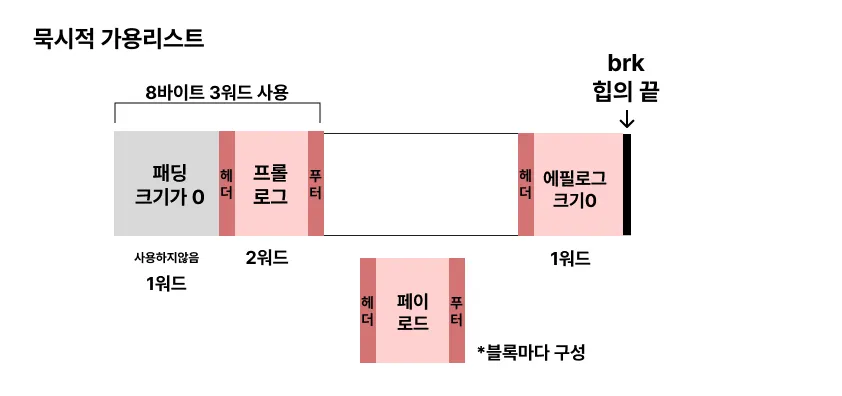
이렇게 구성이 되어있는데 한 블록에 아까 말했듯이 헤더와 페이로드 푸터가 조재한다
헤더는 블록 크기와 할당여부를 기록하고 페이로드는 사용자가 제공되는 실제공간이고,푸터는 블록 크기등을 저장해서 뒤에서부터 블록을 찾을수있게 하는것인데
여기서 빠진게 padding이라는것이다 패딩은 정렬을 맞추기 위해 넣는 빈공간이다 블록에 헤더 푸터 패딩 페이로드가 존재한다!
여기서 brk와 에필로그 관계가 중요한데 brk는 자체 블록이 아니고 커널에게 프로세스가 사용할수있는 힙의 끝은 여기까지다 라고 알려주는 경계일 뿐이다. 그래서 힙을 확장하게 되면 sbrk라는 시스템콜을 호출해서 다시 늘릴수가있다.
그리고 패딩은 모든 블록에 반드시 따로존재하는게 아니고 페이로드 정렬조건에 맞추기 위해 필요한 블록내부에 포함된다..
아까 이미지에서 앞에는 패딩이라는 블록이 1워드를 차지하는데 패딩은 실제로 사용하는 데이터가 없는 8바이트짜리 공간인데 이걸 하는이유는 정렬을 맞추기 위해서 쓴다 8바이트 단위로 주소가 맞아야 하는상황에서 힙의 시작위치를 조정하기 위해서 사용하지 않는 1 워드를 앞에 하나두는것이다!
이제 프롤로그와 에필로그에 대해 설명해보겠다 프롤로그는 사용자가 요청한 메모리가 아니고 약간 가짜(?)블록으로 이해하면 편한데, 프롤로그에서는 푸터와 헤더가 각각이라서 총 2워드이다. 헤더와 푸터는 각각 8바이트를 차지해서 16바이트이고 결국 앞에는 3워드나 차지한다!
에필로그는 왜 다른가 인데 에필로그는 size가 진짜 0이다 근데 왜 8바이트를 차지하지? 라는 의문이 생기는데 이게 size가 의미하는것이랑 실제 헤더가 차지하는 공간이 다르다는것이다. 쉽게 말해서 size = 0은 이 뒤에 더이상 블록없어요 라는 표시다! 그래서 헤더를 저장할 공간 1워드가 생기는것이다..
여기서 그럼 예를 들어보자면 malloc(24)를 주게되면?
만약 사용자가 malloc(24)를 요청하게되면 24+padding+프롤로그+에필로그 총 56바이틀르 사용자에게 할당한다? 이개념은 절때아니고 프롤로그와 에필로그는 사용자에게 할당되는 블록에 포함되지않는다
완전히 따로라는 건데 아래 이미지를 봐보자
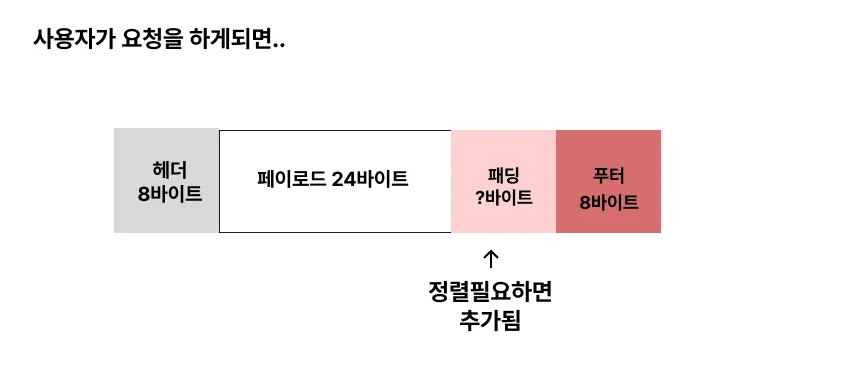
이렇게 헤더+페이로드+푸터+패딩을 고려해서 실제 블록 크기를 계산한다 이렇게 계산이 되면 이제 마지막 아까 묵시적가용리스트의 전체이미지대로 패딩과 프롤로그,에필로그 이렇게 들어가는것이다..
여기부분이 묵시적 가용리스트의 핵심인데 24ㅂ이트만 있으면 되는게 아니라 아까 헤더와 푸터는 8바이트씩 필요하기때문에 총 8+24+8로 40바이트가 필요하다는것이다.. 근데 만약에 16바이트 정렬로 하게되면 아쉽게도 40이 16의 배수가 아니기때문에 48로 올려서 남은 8바이트가 패딩이 되고 실제블록이 48바이트가 된다
마지막#
우린 아직 묵시적 가용리스트 밖에 설명을 안했는데 아직 방법은 많다! 그것은 다음 블로그 2탄에서 뵙고자 한다.. 묵시적 가용리스트의 단점인 시간복잡도가 올라가는것을 보완하고자 나온 방법이 몇가지 더있으니 다음에 소개해보겠다
이글을 읽었으면 어느정도 힙의 가상메모리에 대해 조금 이해하지않았을까? 싶으면 좋겠다 키워드라도 빼서 이해해보면 좋을듯 하다