[CSAPP] 03.hello 프로그램 하나로 컴퓨터 시스템 이해하기
CSAPP 3장 정리
CSAPP | C 코드는 CPU에서 어떻게 동작할까? 어셈블리로 이해하기#
CSAPP를 공부하면서 C 코드가 실제로 CPU에서 어떻게 실행되는지 조금씩 연결해서 보고 있다.
처음에는 mov, lea, cmp, jmp 같은 명령어가 각각 다른 개념처럼 느껴졌다. 그런데 C의 변수와 포인터, 연산, 조건문, 함수, 배열을 하나씩 어셈블리와 연결해보니 결국 레지스터와 메모리를 이용해 값을 계산하고 실행 위치를 이동하는 과정이라는 것을 알게 됐다.
이번에는 C 코드가 어셈블리로 변환될 때 자주 등장하는 명령어를 중심으로 정리해봤다.
1. CPU 레지스터와 C 데이터 타입#
CPU 안에는 데이터를 빠르게 저장하고 계산할 수 있는 레지스터가 있다. x86-64에는 16개의 64비트 범용 레지스터가 있으며, 함수의 인자나 계산 중인 값 등을 저장하는 데 사용된다.
대표적인 레지스터는 다음과 같다.
| 레지스터 | 용도 |
|---|---|
%rax | 함수 반환값 |
%rdi | 첫 번째 인자 |
%rsi | 두 번째 인자 |
%rdx | 세 번째 인자 |
%rcx | 네 번째 인자 |
%r8 | 다섯 번째 인자 |
%r9 | 여섯 번째 인자 |
C에서 데이터 타입마다 크기가 다르듯이 어셈블리 명령어에도 처리할 데이터의 크기가 표시된다.
| C 타입 | 크기 | 접미사 | 예시 |
|---|---|---|---|
char | 1바이트 | b | movb |
short | 2바이트 | w | movw |
int | 4바이트 | l | movl |
long | 8바이트 | q | movq |
여기서 q는 quadword를 의미한다.
그래서 movq를 보면 8바이트 데이터를 이동하는 명령어라고 생각하면 된다.
2. 어셈블리에서 데이터를 표현하는 방법#
어셈블리에서 명령어가 어떤 데이터를 사용할지 표현하는 방법을 오퍼랜드라고 한다.
대표적으로 세 가지가 있다.
즉시값
$42처럼 $가 붙는다. 실제 숫자 42 자체를 의미한다.
레지스터
%rax처럼 %가 붙는다. %rax 레지스터에 들어 있는 값을 의미한다.
메모리
(%rax)처럼 괄호로 표현한다.
이때 %rax에 들어 있는 값을 메모리 주소로 사용해서 해당 주소에 있는 값을 읽거나 쓴다.
C의 포인터와 연결하면 이해하기 쉽다.
%rax → ptr(%rax) → *ptr예를 들어 %rax에 1000이라는 주소가 들어 있고 1000번 메모리에 42가 저장되어 있다면,
%rax → 1000(%rax) → 42가 된다.
따라서 %rax와 (%rax)는 전혀 다른 의미다.
3. mov로 보는 변수와 포인터#
mov는 데이터를 한 곳에서 다른 곳으로 복사하는 가장 기본적인 명령어다.
다음 C 코드를 보자.
long exchange(long *xp, long y){ long x = *xp; *xp = y; return x;}xp가 가리키는 값을 x에 저장하고, xp가 가리키는 메모리에 y를 저장한 뒤 기존 값을 반환하는 함수다.
첫 번째 인자 xp는 %rdi, 두 번째 인자 y는 %rsi를 사용한다고 하면 다음과 같이 표현할 수 있다.
exchange: movq (%rdi), %rax movq %rsi, (%rdi) ret첫 번째 명령어부터 보면,
movq (%rdi), %rax%rdi에 들어 있는 주소를 따라가서 메모리 값을 읽고 %rax에 저장한다.
C 코드로 보면 다음과 같다.
x = *xp;다음은
movq %rsi, (%rdi)이다.
%rsi의 값을 %rdi가 가리키는 메모리에 저장한다.
*xp = y;마지막 ret에서 %rax에 들어 있는 값이 반환값으로 사용된다.
여기서 포인터를 어셈블리와 연결해보면 조금 더 명확하다.
%rdi ↓주소 ↓(%rdi) ↓그 주소에 저장된 값C에서 *xp로 포인터가 가리키는 값을 가져오는 것과 같은 구조다.
또한 일반적인 mov 명령은 메모리에서 메모리로 값을 직접 복사하지 않는다. 필요한 경우 메모리에서 레지스터로 읽은 뒤 레지스터에서 다른 메모리로 저장하는 과정을 거친다.
movq와 movabsq#
movq와 movabsq는 이름이 비슷해서 헷갈릴 수 있다.
movq는 일반적인 8바이트 데이터 이동에 사용한다.
다만 즉시값을 사용할 때는 인코딩 방식에 따라 32비트 즉시값을 64비트로 부호 확장해서 사용하는 경우가 있다.
반면 movabsq는 64비트 크기의 즉시값을 레지스터에 직접 넣어야 할 때 사용할 수 있다.
정리하면 다음과 같다.
movq→ 일반적인 8바이트 데이터 이동
movabsq→ 64비트 전체 크기의 큰 상수를 레지스터에 넣을 때
그래서 모든 64비트 데이터 이동에 movabsq를 사용하는 것은 아니다.
4. 작은 데이터를 큰 레지스터로 옮기기#
작은 크기의 데이터를 더 큰 레지스터로 옮길 때는 남는 상위 비트를 어떻게 채울지 정해야 한다.
zero extension은 남는 상위 비트를 0으로 채우는 방식이다.
예를 들어 1바이트 데이터를 더 큰 레지스터로 확장한다면 상위 비트를 0으로 채운다.
movzbq와 같은 movz 계열 명령어가 이런 작업에 사용된다.
또 하나 기억할 부분이 있다.
x86-64에서는 32비트 레지스터인 %eax에 값을 쓰면 대응하는 64비트 레지스터 %rax의 상위 32비트가 자동으로 0이 된다.
그래서 32비트 연산 결과를 64비트 레지스터에서 사용할 때 별도의 zero extension 명령어가 필요하지 않은 경우가 있다.
5. lea는 주소를 계산한다#
lea는 Load Effective Address의 줄임말이다.
처음에는 C의 & 연산자와 연결해서 생각하기 쉽다.
&A[i]처럼 주소 자체를 계산할 때 사용할 수 있기 때문이다.
하지만 lea는 실제 메모리에 접근하지 않는다.
예를 들어,
leaq (%rdi,%rsi,4), %rax는 메모리에서 값을 읽는 명령이 아니다.
다음 계산을 수행해서 결과를 %rax에 저장한다.
%rax = %rdi + (%rsi × 4)반대로
movq (%rdi,%rsi,4), %rax는 계산된 주소의 메모리에 실제로 접근해서 값을 읽는다.
따라서 둘을 비교하면 다음과 같다.
leaq→ 주소 형태의 계산 결과를 레지스터에 저장
movq→ 계산된 주소의 메모리에 접근해서 값을 가져옴lea는 조건 코드 플래그도 변경하지 않는다.
lea를 이용한 곱셈#
lea는 주소 계산에 사용되는 형태를 이용해서 간단한 곱셈을 표현하는 데도 사용된다.
예를 들어 3*x는
leaq (%rdi,%rdi,2), %rax로 표현할 수 있다.
계산은
x + x × 2 = 3x이다.
5*x는
leaq (%rdi,%rdi,4), %rax로 표현할 수 있다.
x + x × 4 = 5x여기에 7을 더한다면 계산 결과에 add를 사용할 수 있다.
leaq (%rdi,%rdi,4), %raxaddq $7, %rax이처럼 lea는 주소 계산뿐만 아니라 일정한 형태의 산술 계산에도 사용된다.
6. 기본 산술과 비트 연산#
C의 기본 산술 연산은 어셈블리의 여러 명령어로 표현된다.
addq S, D → D = D + Ssubq S, D → D = D - Simulq S, D → D = D × S비트 연산에는 다음과 같은 명령어가 있다.
andqorqxorqxor는 자기 자신과 XOR하면 모든 비트가 0이 된다.
xorq %rax, %rax따라서 %rax를 0으로 만드는 코드에서 자주 볼 수 있다.
쉬프트 연산은 비트를 왼쪽이나 오른쪽으로 이동시키는 연산이다.
salq → 왼쪽 쉬프트sarq → 산술 오른쪽 쉬프트shrq → 논리 오른쪽 쉬프트여기서 sar과 shr에 왜 산술, 논리가 붙는지가 중요했다.
오른쪽 쉬프트를 할 때 빈자리를 어떻게 채우느냐가 다르다.
sar → 기존의 부호 비트를 유지shr → 빈자리를 0으로 채움예를 들어 signed 값에서 음수를 오른쪽으로 이동할 때 sar은 맨 앞의 1을 유지해서 부호를 유지한다.
반면 shr은 항상 0을 채운다.
그래서 sar은 signed 정수의 산술적인 오른쪽 이동에 사용되고, shr은 비트 자체를 논리적으로 이동시킬 때 사용한다.
쉬프트 양은 일반적으로 상수 또는 %cl 레지스터를 사용한다.
7. 조건 플래그와 cmp, test#
C의 if, while, for, switch 같은 제어문은 CPU 입장에서는 조건을 확인하고 실행 위치를 이동하는 과정으로 볼 수 있다.
CPU는 연산 결과에 대한 정보를 조건 코드 플래그에 저장한다.
대표적인 플래그는 다음과 같다.
| 플래그 | 의미 |
|---|---|
| ZF | 결과가 0이면 1 |
| SF | 결과가 음수이면 1 |
| CF | 부호 없는 연산에서 carry 발생 |
| OF | 부호 있는 연산에서 overflow 발생 |
cmp는 두 값을 비교하면서 플래그를 설정한다.
cmpq %rsi, %rdi는 개념적으로
%rdi - %rsi를 계산한 것처럼 플래그를 설정한다.
다만 실제 %rdi와 %rsi의 값 자체는 바뀌지 않는다.
test도 실제 피연산자의 값을 변경하지 않고 플래그를 설정하는 데 사용한다.
testq %rax, %rax처럼 자기 자신과 AND 연산을 하면 %rax가 0인지 등을 확인할 수 있다.
8. if문은 조건부 점프로 바뀐다#
조건 플래그가 설정되면 jxx 계열 명령어가 플래그를 확인하고 특정 위치로 이동한다.
대표적으로 다음과 같은 명령어가 있다.
jmp → 무조건 점프je → 같으면 점프jne → 다르면 점프jg → signed 기준으로 크면 점프jl → signed 기준으로 작으면 점프jle → signed 기준으로 작거나 같으면 점프예를 들어 다음 C 코드가 있다고 하자.
if (x > y) return x - y;else return y - x;어셈블리에서는 다음과 같은 형태가 될 수 있다.
cmpq %rsi, %rdijle .L2
movq %rdi, %raxsubq %rsi, %raxret
.L2:movq %rsi, %raxsubq %rdi, %raxret
흐름을 따라가 보면
x와 y 비교↓x <= y인가?↓YES → else로 점프NO → x - y 실행이다.
C에서 보던 if-else가 CPU에서는 비교 → 플래그 설정 → 조건에 따라 점프하는 형태로 바뀌는 것이다.
9. switch와 점프 테이블#
switch는 여러 개의 case를 비교해야 하기 때문에 컴파일러가 상황에 따라 다양한 형태로 변환할 수 있다.
case 값이 일정한 범위에 몰려 있다면 점프 테이블을 사용할 수 있다.
점프 테이블에는 각 case에 해당하는 코드의 주소가 저장된다.
예를 들어 다음과 같은 형태가 나올 수 있다.
cmpq $3, %rdija .L_defaultjmp *.L_table(,%rdi,8)입력값을 이용해 점프 테이블에서 해당 case의 주소를 찾고 그 주소로 이동하는 방식이다.
다만 switch가 항상 점프 테이블을 사용하는 것은 아니다.
case의 개수나 값의 분포에 따라 여러 번 비교하는 형태로 컴파일될 수도 있다.
그래서 점프 테이블은 switch를 구현하는 방법 중 하나라고 이해하는 것이 좋다.
10. 스택 메모리#
함수를 호출할 때 사용하는 메모리 영역 중 하나가 스택이다.
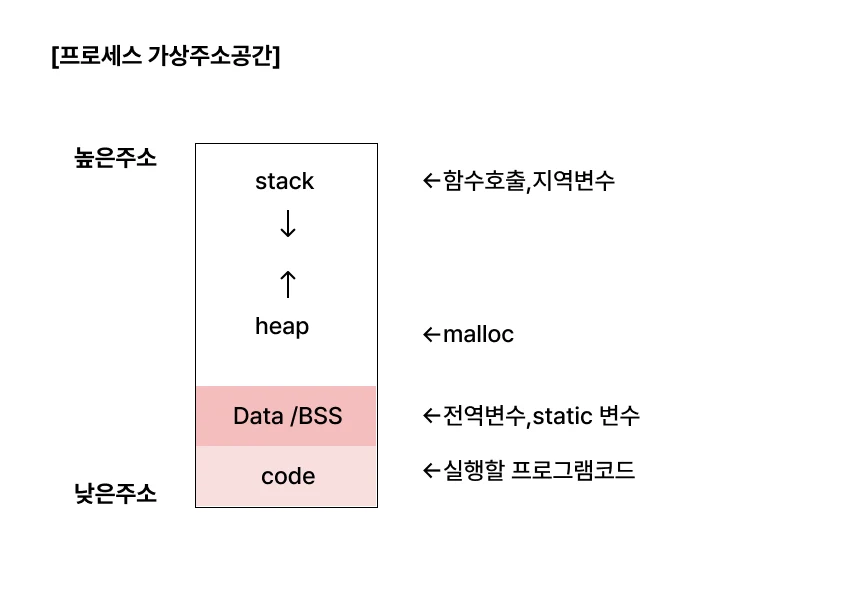
x86-64에서 스택은 일반적으로 높은 주소에서 낮은 주소 방향으로 자란다.
스택의 현재 위치를 가리키는 레지스터가 %rsp다.
pushq는 스택에 값을 추가하고 %rsp를 감소시킨다.
popq는 스택에서 값을 꺼내고 %rsp를 증가시킨다.
개념적으로 보면 다음과 같다.
push↓%rsp 감소↓데이터 저장
pop↓데이터 읽기↓%rsp 증가
64비트 환경에서 pushq, popq는 일반적으로 8바이트 값을 다룬다.
11. 함수 인자와 반환값#
x86-64 System V 호출 규약에서는 정수나 포인터 인자의 처음 6개를 레지스터로 전달한다.
1번째 → %rdi2번째 → %rsi3번째 → %rdx4번째 → %rcx5번째 → %r86번째 → %r97번째 이후의 인자는 스택을 사용한다.
함수의 반환값은 일반적으로 %rax를 통해 전달된다.
그래서 앞에서 살펴본 exchange() 함수에서도
xp → %rdiy → %rsi반환값 → %rax라는 흐름을 볼 수 있다.
12. call과 ret#
함수를 호출할 때 사용하는 대표적인 명령어가 call이다.
call은 함수의 실행 위치로 이동하면서 함수가 끝난 뒤 돌아올 주소를 스택에 저장한다.
흐름은 다음과 같다.
call↓돌아올 주소 저장↓호출한 함수로 이동함수 실행이 끝나면 ret이 스택에 저장된 반환 주소를 가져와 그 위치로 이동한다.
ret↓반환 주소 가져오기↓원래 실행 위치로 복귀그래서 call과 ret을 볼 때는 단순히 함수로 이동하고 돌아오는 명령이라고만 생각하기보다 돌아올 위치를 스택에 저장하고 다시 꺼내는 과정까지 함께 생각하면 이해하기 쉽다.
13. 레지스터 보존 규칙#
함수 A가 함수 B를 호출한다고 생각해보자.
B가 레지스터 값을 변경하면 A가 사용하던 값이 사라질 수 있다.
그래서 호출 규약에서는 레지스터마다 누가 값을 보존해야 하는지 정해놓았다.
callee-saved 레지스터
호출된 함수가 값을 보존해야 한다.
%rbx%rbp%r12%r13%r14%r15함수가 이 레지스터를 사용한다면 기존 값을 저장해두었다가 함수가 끝나기 전에 복원해야 한다.
caller-saved 레지스터
호출한 함수가 필요하면 직접 값을 보존해야 한다.
%rax%rdi%rsi%rdx%rcx%r8%r9%r10%r11호출된 함수는 이 레지스터의 값을 자유롭게 변경할 수 있다.
처음에는 레지스터마다 규칙이 따로 있는 것처럼 보여서 복잡했는데, 결국 함수를 호출했을 때 어떤 값이 유지되어야 하는지에 대한 약속이라고 생각하니 이해하기 편했다.
14. 1차원 배열의 주소 계산#
C에서 배열은 같은 타입의 데이터가 메모리에 연속적으로 저장된다.
따라서 A[i]의 주소는 다음과 같이 계산할 수 있다.
&A[i] = 시작 주소 + (i × 원소 크기)예를 들어 int 배열이라면 int 하나가 4바이트이므로
&A[i] = 시작 주소 + (i × 4)가 된다.
어셈블리에서는 다음과 같은 형태로 나타날 수 있다.
movl (%rdi,%rsi,4), %eax여기서
%rdi → 배열 시작 주소%rsi → 인덱스 i4 → int의 크기라고 생각하면 된다.
주소 자체만 계산한다면 lea를 사용할 수 있다.
leaq (%rdi,%rsi,4), %rax이 경우 메모리의 값을 읽는 것이 아니라 계산된 주소를 %rax에 저장한다.
15. 2차원 배열의 주소 계산#
C의 2차원 배열도 메모리에서는 연속된 공간에 저장된다.
예를 들어
int A[3][5];에서 A[i][j]를 찾으려면 먼저 i번째 행까지 이동한 뒤 j번째 열로 이동해야 한다.
주소는 다음과 같이 계산할 수 있다.
&A[i][j]= 시작 주소 + ((i × 열의 개수) + j) × 원소 크기열의 개수가 5이고 int가 4바이트라면
시작 주소 + ((i × 5) + j) × 4가 된다.
어셈블리에서는 이런 계산이 여러 단계로 나타날 수 있다.
leaq (%rsi,%rsi,4), %raxaddq %rdx, %raxmovl (%rdi,%rax,4), %eax첫 번째 명령에서 i × 5를 계산하고,
두 번째 명령에서 j를 더한다.
마지막으로 4를 곱해서 실제 메모리 위치를 계산한다.
결국 2차원 배열도 CPU 입장에서는 시작 주소에서 얼마나 떨어져 있는지 계산해서 메모리에 접근하는 것이다.
16. 구조체와 메모리 정렬#
구조체는 서로 다른 타입의 데이터를 하나로 묶어서 저장할 수 있다.
struct Student { int id; char grade; long score;};구조체의 각 멤버는 시작 주소에서 일정한 오프셋을 갖는다.
그런데 멤버를 작성한 순서대로 빈틈없이 붙여놓는 것은 아니다.
각 데이터 타입에는 정렬 요구사항이 있고, 이를 맞추기 위해 패딩이 들어갈 수 있다.
일반적인 x86-64 환경에서 다음과 같이 배치될 수 있다.
offset 0 ~ 3 → idoffset 4 → gradeoffset 5 ~ 7 → paddingoffset 8 ~ 15 → scoreint는 4바이트, char는 1바이트, long은 8바이트라고 하면 실제 데이터는 총 13바이트다.
하지만 score를 8바이트 정렬에 맞춰 오프셋 8에서 시작시키기 위해 3바이트의 패딩이 들어간다.
그래서 구조체 전체 크기는 16바이트가 된다.
패딩은 다른 변수의 저장 공간으로 사용할 수 있는 빈 공간이 아니다. 그 구조체의 메모리 레이아웃에 포함된 공간이다.
어셈블리에서는 구조체의 시작 주소가 %rdi에 있다면 score에 다음과 같이 접근할 수 있다.
movq 8(%rdi), %rax%rdi에 구조체 시작 주소가 들어 있고 8이라는 오프셋을 더해서 score의 위치를 찾는 것이다.
배열이
시작 주소 + 인덱스 × 원소 크기로 접근한다면 구조체의 멤버는
시작 주소 + 멤버 오프셋으로 접근한다고 생각하면 된다.
마무리#
이번 내용을 정리하면서 C 코드가 CPU에서 실행되는 모습을 조금 더 구체적으로 볼 수 있었다.
처음에는 mov, lea, cmp, jmp 같은 명령어를 각각 따로 외워야 하는 것처럼 느껴졌다.
그런데 연결해서 보니 흐름은 생각보다 단순했다.
C 변수↓레지스터 또는 메모리에 저장↓연산↓조건 플래그 설정↓조건에 따라 점프↓함수 호출과 스택 사용↓배열과 구조체의 주소 계산특히 포인터를 공부할 때 *ptr이 단순한 C 문법처럼 느껴졌는데, 어셈블리에서 (%rax)처럼 레지스터에 들어 있는 주소를 따라가 메모리의 값을 읽는 모습을 보면서 둘이 연결되기 시작했다.
배열도 비슷했다.
C에서는 A[i]라고 간단하게 쓰지만 CPU에서는 결국 시작 주소와 인덱스, 원소 크기를 이용해 실제 메모리 주소를 계산하는 과정이었다.
아직 어셈블리 코드를 보면 바로 읽히지는 않지만, C에서 배운 포인터와 배열, 함수가 CPU의 레지스터와 메모리에서 어떻게 표현되는지 조금씩 연결해서 볼 수 있게 된 것 같다.